Première Analyse en Statistique Descriptive
Introduction
Vous allez effectuer votre Première Analyse en Statistique Descriptive (PASD) avec l'environnement de développement libre et gratuit, RStudio.
Ce travail s'effectuera en groupe de 4 ou 5 étudiants, pour un total de 10 groupes sur la promotion.
Ce projet consiste à réaliser une étude statistique comparative entre deux systèmes agro-alimentaires contrastés — l'Europe occidentale et l'hémisphère sud (par exemple la France et le Kenya) — en s'appuyant sur les données de la FAO.
À l'aide de RStudio et de l'interface Quarto, vous allez concevoir un tableau de bord interactif (Dashboard) qui synthétise les dynamiques de production végétale, l'efficacité des rendements et les enjeux de sécurité alimentaire sur les deux dernières décennies.
Ce travail vous place dans une posture d'ingénieur analyste : il ne s'agit plus seulement de calculer des chiffres, mais de faire parler les données pour mettre en lumière les forces et les vulnérabilités de modèles agricoles différents.
Objectifs
- Maîtrise de la « data ingénierie » : extraire, nettoyer et structurer des données brutes complexes (gestion des unités, traitement des valeurs manquantes).
- Application des statistiques descriptives : mobiliser les outils de base (moyennes, écarts-types, coefficients de variation) pour quantifier la stabilité des récoltes et comparer les productivités nationales.
- Analyse agronomique critique : interpréter les résultats graphiques (courbes de rendement, surfaces cultivées) à la lumière des contextes pédoclimatiques et socio-économiques.
- Communication scientifique : synthétiser des informations multidimensionnelles dans un outil visuel professionnel et ergonomique.
Pour mieux appréhender les attentes, consultez cet exemple de dashboard interactif. Il illustre la manière dont les données brutes de la FAO sont transformées en indicateurs visuels et dynamiques pour l'aide à la décision.
Dossier de travail
Vous pouvez retrouver via ce lien la liste des groupes.
- Groupe 1Irlande et Madagascar
- Groupe 2France et Cameroun
- Groupe 3Italie et Mozambique
- Groupe 4France et Inde
- Groupe 5Allemagne et Thaïlande
- Groupe 6Irlande et Fidji
- Groupe 7Allemagne et Botswana
- Groupe 8France et Gabon
- Groupe 9Belgique et Congo
Il vous est demandé de synchroniser votre dossier de travail sur votre ordinateur personnel, comme indiqué à ce lien.
Bases de données
Extraire les données de souveraineté alimentaire. L'objectif est de récupérer quatre fichiers CSV distincts. Rendez-vous sur FAOSTAT, puis dans la barre de menu supérieure cliquez sur l'onglet Données.
Production
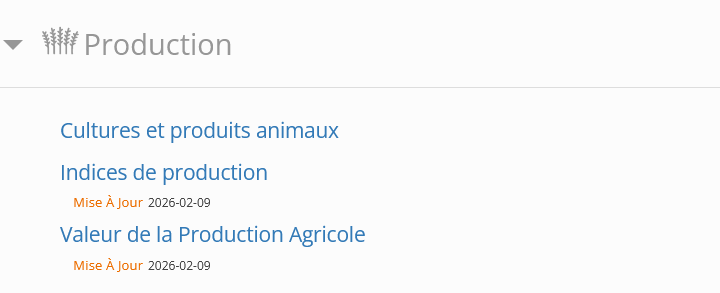
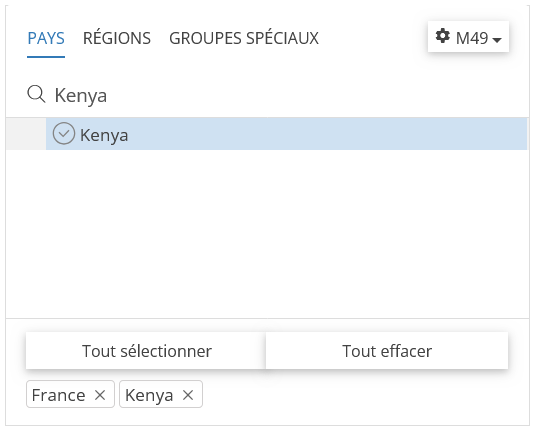
Sélectionnez Cultures et produits animaux. Dans le quadrant PAYS, sélectionnez les deux pays de votre groupe (ici France et Kenya).
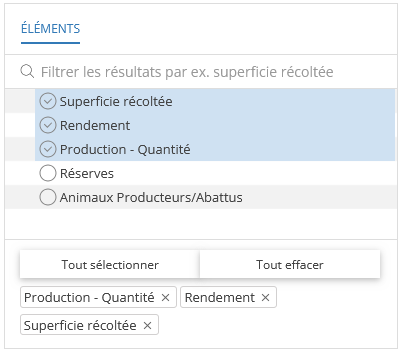
Dans Éléments : Superficie récoltée, Rendement et Production - Quantité.
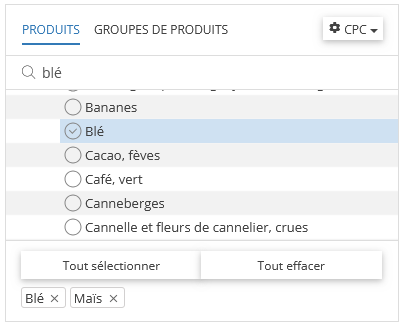
Dans Produits : Maïs et Blé.
Dans Années : Tout sélectionner, puis cliquez sur Télécharger les données.
Valeur de la production
Sélectionnez Valeur de la production agricole.
| Pays | France et Kenya |
|---|---|
| Éléments | Production brute (millier US$) |
| Groupes de produits | Agriculture (total) et Élevage (total) |
| Année | Toutes les années |
Sécurité alimentaire et nutrition
Sélectionnez Domaine de la sécurité alimentaire.
| Pays | France et Kenya |
|---|---|
| Éléments | Valeur |
| Produits | Indicateurs 21010 et 21013 |
| Année | Toutes les années |
Démographie
Sélectionnez Séries temporelles annuelles.
| Pays | France et Kenya |
|---|---|
| Éléments | Population totale, Population rurale et Population urbaine |
| Produits | Population - Estimations |
| Année | Toutes les années |
Les bases récupérées sur FAOSTAT doivent être sauvegardées dans le dossier data_raw de votre OneDrive PASD, avec les dénominations : production.csv, valeur_production.csv, securite_alimentaire.csv et demographie.csv.
Première analyse
L'objectif est de réaliser une analyse statistique exploratoire (univariée et bivariée) sur l'une des bases téléchargées, pour le binôme de pays de votre groupe. Ce travail doit être effectué exclusivement dans un script R (fichier .R).
Les commentaires et tout texte explicatif doivent être précédés du symbole # pour ne pas bloquer l'exécution du code.
Instructions de rédaction :
- Introduction : courte motivation du choix des pays et des variables sélectionnées.
- Préparation des données : partie technique, mais commentée.
- Analyse univariée : pour une variable, pour chaque pays. Interprétez vos résultats.
- Analyse bivariée : pour deux variables, pour chaque pays. Interprétez vos résultats.
- Conclusion : interprétation globale de vos résultats.
Le code R ci-dessous montre la structure que votre fichier doit avoir.
# ========================================
# ANALYSE EXPLORATOIRE : FRANCE / KENYA
# Groupe : Noms Etudiants ...
# ========================================

# ----------------
# | Introduction |
# ----------------

# Nous avons choisi de comparer la France et le Kenya sur la culture du Blé.
# Cette comparaison oppose un leader mondial de l'exportation (France) à un
# pays dont la sécurité alimentaire dépend de ses rendements céréaliers (Kenya).
# ...

# ---------------------------
# | Préparation des données |
# ---------------------------

# [Insérez ici votre code pour la préparation des données]

# ---------------------
# | Analyse univariée |
# ---------------------

# [... ne pas oublier d'interpréter vos résultats ...]

# --------------------
# | Analyse bivariée |
# --------------------

# [... ne pas oublier d'interpréter vos résultats ...]

# --------------
# | Conclusion |
# --------------

# [Tenter une conclusion globale de votre analyse]Votre code doit être intelligible pour un tiers. Des commentaires abondants et pertinents sont un critère essentiel de réussite. Explicitez vos choix (pourquoi cette fonction ? pourquoi ce graphique ?) et interprétez vos résultats directement en commentaires : un code qui « parle » est le signe d'une analyse maîtrisée.
Exemple France / Kenya
Pour vous guider, voici une démonstration basée sur le fichier production.csv pour le couple France / Kenya. Cette étude compare la filière blé sur les deux dernières décennies à travers trois indicateurs : surfaces cultivées, rendements à l'hectare et production totale.
Préparation des données
On a besoin du package tidyverse, puis on importe les données.
library(tidyverse)

# IMPORTATION DES DONNEES
raw_fao_prod <- read.csv("data_raw/production.csv")
On réorganise les données pour obtenir un tableau plus facile à manipuler.
# NETTOYAGE DES DONNEES
fao_prod <- raw_fao_prod |>
  select(Zone, Produit, Élément, Année, Unité, Valeur) |>
  mutate(
    Zone    = str_trim(Zone),
    Produit = str_trim(Produit),
    Élément = str_trim(Élément),
    Unité   = str_trim(Unité),
    Produit = case_when(
      Produit == "Maïs" ~ "Mais",
      Produit == "Blé"  ~ "Blé",
      TRUE ~ Produit
    ),
    Élément = case_when(
      Élément == "Superficie récoltée" ~ "Surface",
      Élément == "Rendement"           ~ "Rendement",
      Élément == "Production"          ~ "Production",
      TRUE ~ Élément
    )
  )
On vérifie la cohérence des unités.
table(fao_prod$Élément, fao_prod$Unité) ha kg/ha tonnes
Production 0 0 256
Rendement 0 256 0
Surface 256 0 0On réarrange le tableau pour placer Production, Rendement et Surface en colonnes.
production <- fao_prod |>
  select(Zone, Produit, Année, Élément, Valeur) |>
  pivot_wider(
    names_from  = Élément,
    values_from = Valeur
  ) |>
  rename(
    Pays    = Zone,
    Céréale = Produit
  )
Analyse univariée
On se concentre sur le rendement (kg/ha), indicateur principal de la performance technique.
france_rdt_ble <- production |>
  filter(Pays == "France", Céréale == "Blé") |>
  select(Rendement)

kenya_ble <- production |>
  filter(Pays == "Kenya", Céréale == "Blé") |>
  select(Surface, Rendement, Production)
Le tableau ci-dessous synthétise les indicateurs de tendance centrale et de dispersion.
| Statistique | France (kg/ha) | Kenya (kg/ha) |
|---|---|---|
| Min | 2 395,00 | 921,20 |
| 1ᵉʳ Qu. | 4 580,75 | 1 518,15 |
| Médiane | 6 373,60 | 1 809,95 |
| Moyenne | 5 763,68 | 1 934,53 |
| 3ᵉ Qu. | 7 007,65 | 2 194,72 |
| Max | 7 800,80 | 3 199,10 |
| Écart-type | 1 521,05 | 574,85 |
| Variance | 2 313 591,97 | 330 454,47 |
Le rendement moyen français est environ 3,5 fois supérieur à celui du Kenya. La médiane française est très proche de sa moyenne, suggérant une distribution symétrique ; au Kenya, la variance élevée par rapport à la moyenne indique une instabilité plus marquée des récoltes.
Le boxplot permet de visualiser la stabilité des systèmes.
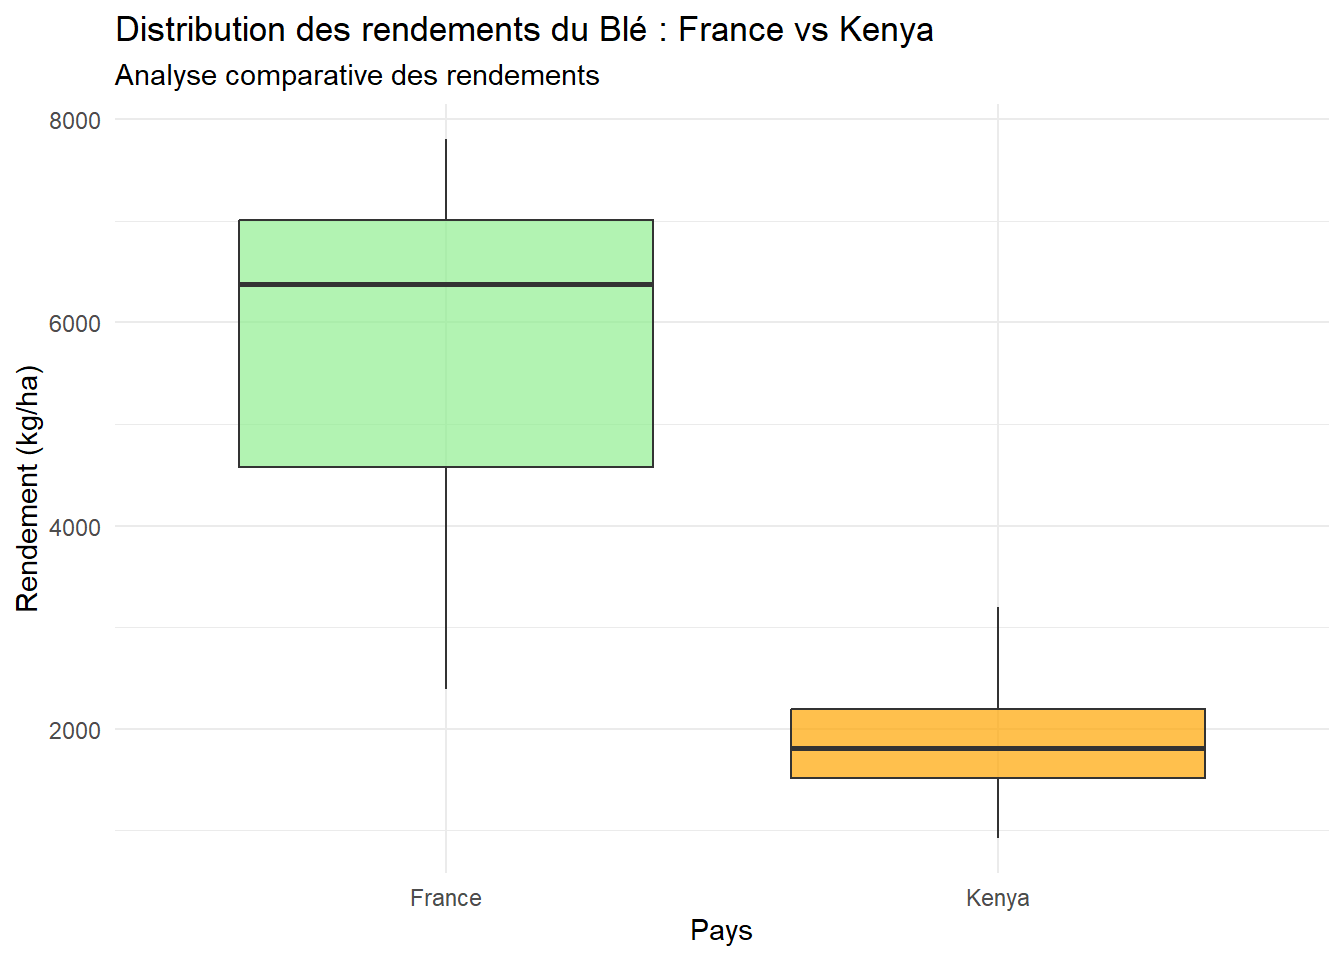
Le boxplot de la France est situé très haut sur l'axe des ordonnées, témoignant d'une haute performance maîtrisée ; le Kenya présente une boîte plus basse et plus écrasée.
L'histogramme montre si les rendements suivent une distribution normale (cloche) ou s'ils sont instables.
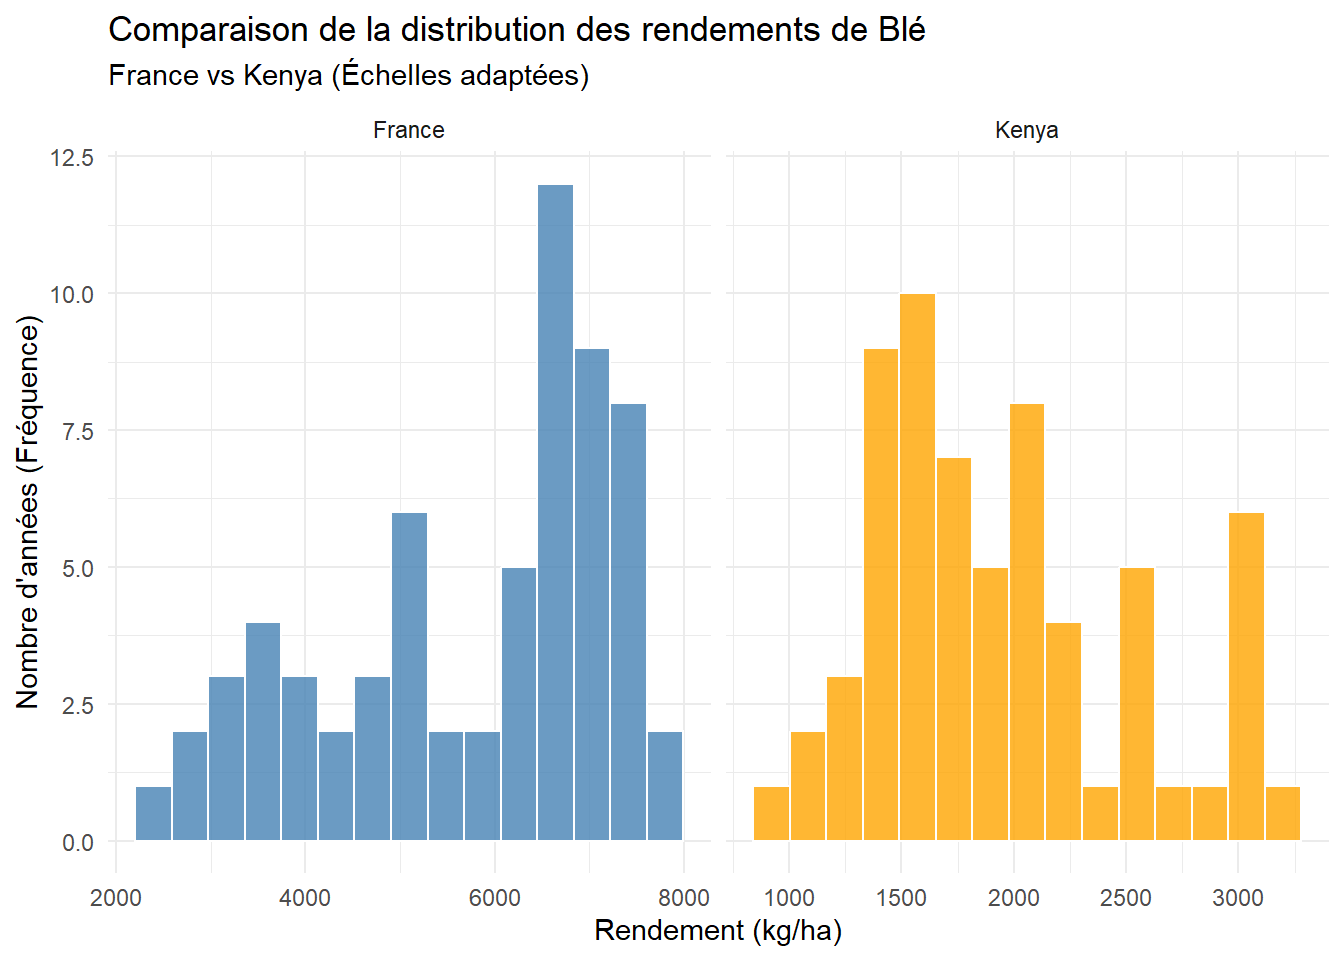
Avec des échelles adaptées, la France possède une distribution relativement régulière, tandis que celle du Kenya est plus irrégulière.
Analyse bivariée
Question d'ingénieur agronome : comment un pays augmente-t-il sa production — en améliorant ses techniques ou en agrandissant ses terres ? On étudie ici les variables Production et Surface.
france_ble_prod_surf <- production |>
  filter(Pays == "France", Céréale == "Blé") |>
  select(Production, Surface)

kenya_ble_prod_surf <- production |>
  filter(Pays == "Kenya", Céréale == "Blé") |>
  select(Production, Surface)
On trace le nuage de points de la production par rapport aux surfaces cultivées, avec une droite de régression.
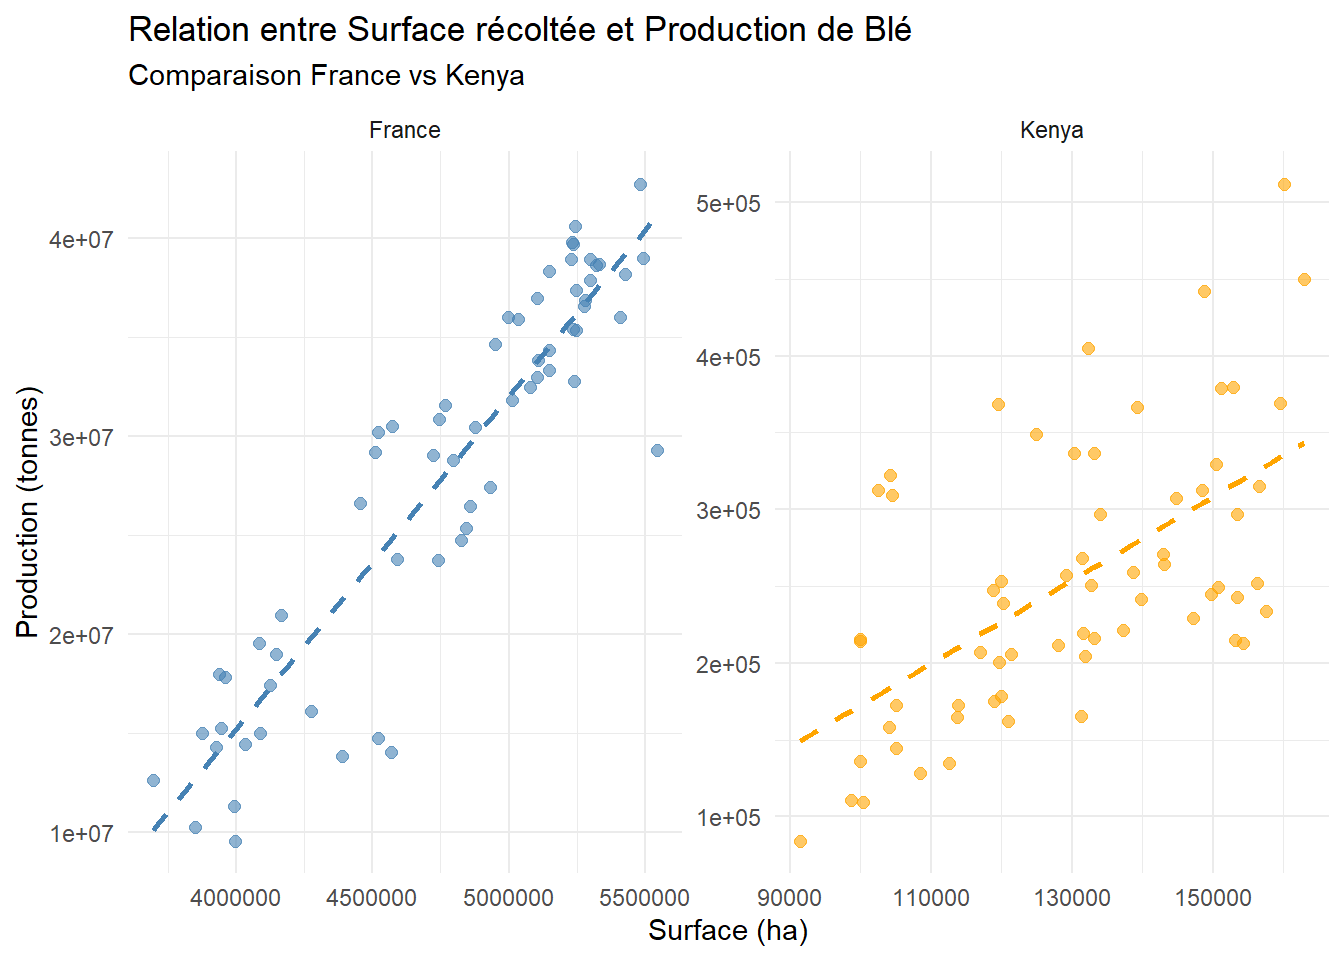
Le nuage révèle deux stratégies : pour la France la relation est très linéaire (la production suit la gestion des surfaces) ; pour le Kenya les points sont plus dispersés (la surface ne suffit pas à expliquer la production).
FRANCE :
 Équation : y = 16.81 x + -52033200
 Corrélation (R) : 0.918

KENYA :
 Équation : y = 2.71 x + -98698.34
 Corrélation (R) : 0.595
Avec un coefficient proche de 1 (0,92), la France affiche une corrélation quasi-parfaite : le système est prévisible. Le Kenya (0,60) montre une dépendance beaucoup plus aléatoire. La pente française étant plus raide, chaque hectare supplémentaire cultivé en France « rapporte » beaucoup plus de tonnes qu'au Kenya.
De la donnée au Dashboard
Ouvrez le fichier dashboard.qmd déjà présent dans votre OneDrive partagé. Nous allons construire un dashboard pour illustrer votre travail à partir des bases FAOSTAT. L'intérêt de Quarto est triple : fiabilité des résultats (le code est lié aux graphiques), synthèse multidimensionnelle et support d'aide à la décision « prêt à l'emploi ».
Écosystème Quarto
Un fichier Quarto (.qmd) est un document hybride reposant sur trois piliers : l'en-tête YAML (la « carte d'identité » du document), le Markdown (le texte narratif) et les chunks de code R (qui exécutent les calculs et génèrent les graphiques). Quarto compile ces éléments pour produire un dashboard organisé en lignes et colonnes.
En-tête
Éditez le fichier .qmd avec cet en-tête :
---
title: "Première Analyse en Statistique Descriptive"
format:
  dashboard:
    logo: img/Logo_simple_ISTOM_Couleurs_HD.png
    theme: [sandstone, theme/custom.scss]
    nav-buttons: [link-45deg]
    github: https://github.com/votre-depot
fig-width: 10
fig-asp: 0.4
editor_options:
  chunk_output_type: console
---
Structure globale
La Sidebar reste visible sur tous les onglets. Collez ce bloc juste après les tirets de fermeture ---, dans un chunk R.
#  {.sidebar}

Outil statistiques pour :

|                     |
|---------------------|
| **Kenya** (Afrique) |
| **France** (Europe) |

|                       |
|-----------------------|
| **ISTOM**             |
| **Promotion 116**     |
| **Année 2025 - 2026** |
| **PASD**              |

::: {.callout-note collapse="true"}
## Auteur-es
| Nom Prénom |
:::
La hiérarchie des titres structure l'affichage : les pages (#) créent des onglets, les lignes (## Row) des rangées horizontales, les colonnes (### Column) divisent une ligne verticalement.
# Productions

## Row {height="20%"}
### Rendement Moyen

## Row {height="80%"}
### Comparaison des cultures

# Analyse Macro & Démo

## Row
### Poids Économique
### Dynamique Démographique

# Données
Loading packages
Dans un chunk R, chargez les packages de traitement et de visualisation.
library(tidyverse)
library(scales)
library(DT)
library(gt)

# Thème visuel proposé pour les graphiques
theme_set(theme_minimal(base_size = 16))
Importation des données
Les fichiers .csv récupérés sur FAOSTAT sont enregistrés dans le dossier data_raw.
# IMPORTATION DES DONNEES
raw_fao_prod        <- read.csv("data_raw/production.csv")
raw_fao_val_prod    <- read.csv("data_raw/valeur_production.csv")
raw_fao_secu_alim   <- read.csv("data_raw/securite_alimentaire.csv")
raw_fao_demographie <- read.csv("data_raw/demographie.csv")
Coming.
coming.
Mise en forme par Antoine Géré.